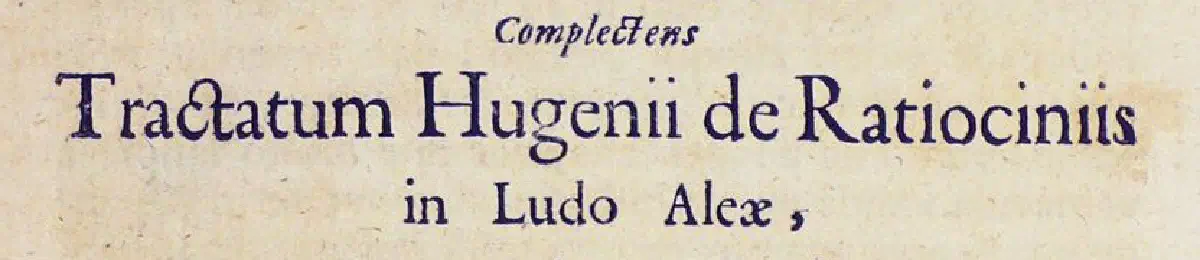
Ars Conjectandi: primera página de la primera parte, con el tratado de Huygens sobre los juegos de azar — El azar, medido: de una muestra a una conclusión
Jakob Bernoulli, Ars Conjectandi (Thurneysen, Basilea); escaneo de la Fondazione Mansutti, 1713 · Public domain · Wikimedia Commons
Itinerarios / medio

El azar, medido: de una muestra a una conclusión

Diez capítulos, ocho con figura interactiva, sobre cómo se saca una conclusión de unos datos que podrían haber salido de otra manera, y cuándo no se puede.

10 capítulos · 11,642 palabras · 59 min · cada capítulo es un artículo de la enciclopedia

Toda la estadística que va más allá de describir unos datos se enfrenta a la misma pregunta: si se hubiera tomado otra muestra, ¿cuánto habría cambiado el resultado? Este itinerario la recorre en diez capítulos, y en ocho de ellos hay una figura con la que el azar se puede repetir las veces que haga falta, que es la manera más rápida de entender lo que las fórmulas resumen.

Los tres primeros son sobre el azar mismo. La ley de los grandes números explica por qué la proporción de caras se acerca a la mitad y por qué eso no significa que el azar compense nada. El problema del cumpleaños enseña lo mal que se calcula a ojo la probabilidad de una coincidencia, y el método de Montecarlo convierte esa misma aleatoriedad en una herramienta de cálculo que nació en Los Álamos. Los cuatro siguientes son sobre estimar: el teorema central del límite da la forma de campana que tienen casi todas las fluctuaciones, el intervalo de confianza la traduce en un margen de error, el bootstrap consigue ese margen sin fórmulas remuestreando los propios datos, y el tanque alemán enseña a estimar lo que no se ve con los números de serie de unos pocos tanques capturados, y es el caso en el que el bootstrap falla.

Los tres últimos son sobre decidir, y es donde se cometen los errores que llenan la crisis de replicación. El valor p mide lo compatible que es un resultado con la ausencia de efecto; la potencia, la probabilidad de detectar un efecto que sí existe, y por qué un estudio pequeño que acierta exagera casi siempre; las comparaciones múltiples, lo que pasa cuando se prueban veinte cosas y solo se cuenta la que salió.

Conviene haber hecho antes Estadística descriptiva, de cero, o saber qué son una media y una desviación típica. No hace falta más matemáticas que las del bachillerato, y las pocas fórmulas que aparecen se pueden saltar sin perder el hilo, porque las figuras cuentan lo mismo.

Capítulo 1 de 10

La ley de los grandes números

Matemática y estadística 1361 palabras artículo suelto ↗

La ley de los grandes números (en inglés, law of large numbers) dice que la media de muchas repeticiones independientes de un mismo experimento se acerca a su valor esperado a medida que crece el número de repeticiones. Si una moneda tiene la misma probabilidad de salir cara que cruz, la proporción de caras en diez lanzamientos puede ser cualquier cosa entre el cero y el uno, en mil rara vez sale de la franja entre el 47 y el 53 por ciento, y en un millón no se separa del 50 más que unas décimas. Es el resultado que convierte la probabilidad, que habla de lo que puede pasar en un caso, en frecuencia, que es lo que se observa cuando los casos se acumulan, y sin él no existirían ni las encuestas ni los seguros ni la inferencia estadística entera.

La figura lanza cinco series a la vez. Cada línea es la proporción de aciertos acumulada de una serie, y la franja naranja marca dos errores típicos alrededor de la probabilidad verdadera, que es donde deberían caer casi todas las series en cada momento. Al principio las cinco líneas saltan de un extremo a otro; hacia los cien lanzamientos ya van juntas, y a los diez mil son casi una sola raya pegada a la probabilidad. La tabla de debajo cuenta otra historia, que es la mitad de la ley que casi nadie aprende.

Interactivo Cinco series independientes de lanzamientos. Arriba, la proporción de aciertos acumulada, que converge a la probabilidad dentro de una franja que se estrecha como 1/√n. Abajo, el desvío en número de aciertos respecto a lo esperado, que no converge a cero: crece como √n. La proporción se estabiliza porque el desvío se diluye en un total cada vez mayor, no porque el azar lo corrija.

La columna del desvío resta, en cada serie, los aciertos obtenidos menos los que tocarían según la probabilidad. Tras diez lanzamientos de moneda, lo normal es ir una o dos caras por encima o por debajo de cinco. Tras diez mil, lo normal es ir unas cuarenta por encima o por debajo de cinco mil, y ese desvío absoluto no deja de crecer: aumenta con la raíz cuadrada del número de lanzamientos. La proporción se acerca a la mitad a pesar de ello, porque cuarenta caras de más sobre diez mil son un 0,4 por ciento y sobre un millón serían, con un desvío típico de quinientas, un 0,05. La ley no dice que las caras y las cruces acaben igualadas. Dice que su diferencia crece más despacio que el total.

Esa distinción es la que separa la ley de su caricatura, la falacia del jugador (gambler’s fallacy): la creencia de que, después de una racha de rojos en la ruleta, el negro «se debe» y es más probable. La ruleta no tiene memoria y cada tirada es independiente de las anteriores, así que la probabilidad del negro sigue siendo la misma después de veinte rojos que después de ninguno. El caso más citado ocurrió en el casino de Montecarlo el 18 de agosto de 1913, cuando el negro salió veintiséis veces seguidas y los jugadores perdieron fortunas apostando al rojo a partir de la décima o la decimoquinta. Lo que la ley promete es que esa racha acabará pesando poco en la proporción de dentro de un millón de tiradas, porque quedará sumergida entre las demás, no que la ruleta vaya a devolver lo que se llevó.

Amos Tversky y Daniel Kahneman dieron nombre en 1971 a una versión más sutil del mismo error, que encontraron en psicólogos profesionales: la creencia en la ley de los pequeños números (belief in the law of small numbers). Consiste en esperar que una muestra pequeña se parezca a la población tanto como una grande, y lleva a sobrevalorar resultados obtenidos con pocos casos, a esperar que una réplica salga igual que el original y a buscar explicaciones para desviaciones que son puro ruido. La ley de los grandes números es, precisamente, una ley de números grandes, y no dice nada de cuánto se parece a la probabilidad una muestra de veinte.

La primera demostración es de Jakob Bernoulli, que trabajó en ella unos veinte años y la llamó su teorema áureo. Se publicó en 1713, ocho años después de su muerte, en la cuarta parte del Ars Conjectandi, y lo que demuestra es que, con una urna de proporción conocida, la probabilidad de que la frecuencia observada se aleje de esa proporción más de un margen fijado tiende a cero con el número de extracciones. Bernoulli quiso además dar una cifra y calculó que, con una urna de tres bolas blancas por cada dos negras, hacían falta 25.550 extracciones para tener una certeza de mil contra uno de que la frecuencia quedaba a menos de una quincuagésima de la verdadera. La cota era muy pesimista, y los cálculos posteriores con la distribución normal la redujeron a unos pocos miles, pero hay historiadores, como Stephen Stigler, que ven en aquel número desalentador una de las razones por las que Bernoulli dejó el libro sin terminar. El nombre de ley de los grandes números se lo puso Siméon Denis Poisson en 1837, en un tratado sobre la probabilidad de que los jurados acierten.

Lo que Bernoulli demostró se llama hoy ley débil (weak law): para cualquier margen, la probabilidad de estar fuera de él tiende a cero. La ley fuerte (strong law), que Émile Borel demostró para las monedas en 1909 y Andréi Kolmogórov generalizó en los años treinta, dice algo más exigente: que con probabilidad uno, la sucesión entera de proporciones converge al valor esperado, de modo que las series que se desvían para siempre, aunque existan en teoría, tienen probabilidad nula. En la figura se ve la diferencia sin fórmulas: la ley débil habla de dónde está cada serie en un momento dado, y la fuerte, de la trayectoria completa de cada línea.

Mientras tanto, hubo quien lo comprobó a mano. El conde de Buffon lanzó una 4.040 veces en el siglo XVIII y obtuvo 2.048 caras. Karl Pearson llegó a 24.000 lanzamientos con 12.012 caras. El más célebre lo hizo John Kerrich, profesor de matemáticas en Johannesburgo, que estaba de visita en Copenhague cuando Alemania invadió Dinamarca en 1940 y pasó la guerra internado en un campo de Jutlandia. Allí, con un compañero de encierro, lanzó una moneda diez mil veces y anotó cada resultado. Obtuvo 5.067 caras, un desvío de 67 sobre lo esperado y una proporción de 0,5067, y publicó en 1946 las tablas completas junto con las curvas de la proporción acumulada, que tienen exactamente la forma de las de la figura.

La ley tiene condiciones, y la principal es que el valor esperado exista. Hay distribuciones que no lo tienen, como la de Cauchy, que es la del punto donde cae sobre una pared la luz de una linterna apuntada en una dirección al azar: sus colas son tan pesadas que un solo valor extremo puede mover la media de cualquier muestra, y la media de un millón de observaciones no es más estable que una sola. Con colas menos extremas, como las de la distribución de Pareto que describe las fortunas, la media converge, pero tan despacio que en la práctica la de una muestra depende sobre todo de si ha entrado en ella algún multimillonario. La otra condición es la independencia, o algo parecido: si los casos se contagian unos a otros, como las opiniones en una red o las quiebras en una crisis, la ley no garantiza nada.

Donde se cumple, es el cimiento de negocios enteros. Una aseguradora no sabe qué casa se va a quemar, pero con cien mil pólizas sabe con bastante precisión cuántas, y cobra en consecuencia. Un casino no sabe quién va a ganar esta noche, pero con la ventaja del cero en la ruleta, 1/37 de cada apuesta, sabe cuánto ganará en un año. Una encuesta con mil entrevistas acierta la proporción de votantes con un margen de unos tres puntos por la misma razón, siempre que las entrevistas sean una muestra al azar, que es donde suelen fallar, como explica el artículo sobre la encuesta electoral. La ley de los grandes números dice a qué valor se acerca la media; el teorema central del límite completa el cuadro diciendo con qué forma se reparten sus fluctuaciones alrededor de ese valor, que es la forma de campana que dibuja la franja naranja.

Capítulo 2 de 10

El problema del cumpleaños

Matemática y estadística 1133 palabras artículo suelto ↗

El problema del cumpleaños (en inglés, birthday problem) pregunta cuántas personas tiene que haber en una sala para que sea más probable que improbable que dos de ellas cumplan años el mismo día. La respuesta es 23, y casi todo el mundo la encuentra increíble la primera vez. Con 23 personas, la probabilidad de al menos una coincidencia es del 50,7 por ciento; con 40 pasa del 89, y con 57, del 99. Para tener la certeza absoluta hacen falta 366, pero la certeza práctica llega mucho antes: en un aula de 70 alumnos, que no haya ningún cumpleaños repetido es un suceso de menos de uno entre mil.

No es una paradoja en sentido estricto, porque no hay ninguna contradicción lógica, sino un choque entre el resultado y la intuición, y la figura permite ver de dónde viene el choque. Arriba hay un calendario del año con un cuadro por día; cada vez que se reúne un grupo, los días de sus cumpleaños se pintan en negro, y los que se repiten, en naranja. Abajo están dos curvas. La naranja es la probabilidad de que coincidan dos personas cualesquiera del grupo; la discontinua, la de que alguien del grupo cumpla años el mismo día que tú.

Interactivo Elige cuántas personas hay en la sala y reúne grupos al azar. Con 23, más o menos la mitad de los grupos tiene un día repetido. La curva naranja es la probabilidad de alguna coincidencia entre dos cualesquiera; la discontinua, la de que alguien coincida contigo, que con 23 personas no llega al 6 %. La intuición suele responder a la segunda pregunta cuando se le hace la primera.

La distancia entre las dos curvas es toda la explicación. Cuando alguien piensa en el problema, casi siempre se pregunta sin darse cuenta si otra persona de la sala cumple años el mismo día que él, y esa probabilidad es pequeña de verdad: con 22 personas más, cada una tiene 364 posibilidades sobre 365 de no coincidir, y la probabilidad de que alguna coincida es de un 5,9 por ciento. Para que esa segunda curva llegue a la mitad hacen falta 253 personas. Pero la pregunta no era esa. Con 23 personas no hay 22 comparaciones sino todas las parejas posibles, que son 23 × 22 / 2 = 253, y cada una de esas parejas es una oportunidad de coincidencia. El número de parejas crece con el cuadrado del grupo, y la intuición, que cuenta personas, crece en línea recta.

El cálculo exacto se hace por el lado contrario, contando la probabilidad de que no coincida nadie. La primera persona puede cumplir años cualquier día. La segunda tiene que evitar uno, con probabilidad 364/365; la tercera, dos, con 363/365, y así sucesivamente. La probabilidad de que las n tengan días distintos es el producto de todas esas fracciones, y la de al menos una coincidencia es uno menos ese producto:

P(n)=1−365365⋅364365⋯365−n+1365≈1−e−n(n−1)/730 P(n) = 1 - \frac{365}{365}\cdot\frac{364}{365}\cdots\frac{365-n+1}{365} \approx 1 - e^{-n(n-1)/730}

La aproximación de la derecha deja ver la forma del resultado: la probabilidad depende del número de parejas, n(n − 1)/2, dividido por el número de días. Por eso la mitad se alcanza cuando el grupo anda por la raíz cuadrada de los días posibles, multiplicada por un factor de 1,18. Con 365 días, esa raíz es 19 y el umbral cae en 23. Con un calendario de un millón de días, bastarían unas 1.200 personas.

La historia del problema es confusa, como corresponde a un acertijo que circulaba de boca en boca. La primera versión publicada suele atribuirse al matemático austríaco Richard von Mises, que la incluyó en 1939 en un artículo sobre problemas de ocupación escrito en Estambul, donde se había exiliado. El matemático inglés Harold Davenport contaba que él la había propuesto antes, sin llegar a publicarla. Quien la popularizó fue William Feller, que la incluyó en 1950 en el primer volumen de su manual de probabilidad, del que pasó a casi todos los que vinieron después.

Hay dos supuestos en el cálculo que la realidad no cumple, y ninguno de los dos salva a la intuición. El primero es que los 365 días son igual de probables. No lo son: en casi todos los países hay meses con más nacimientos que otros, y en los hospitales con muchos partos programados hay menos nacimientos en fin de semana. Pero cualquier desigualdad en el reparto hace las coincidencias más probables, no menos, porque concentra a la gente en menos días, así que 23 es el peor caso. El segundo supuesto es que no hay gemelos en la sala, y un par de gemelos resuelve el problema con probabilidad uno. El 29 de febrero, que se suele ignorar, apenas cambia la cifra.

Persi Diaconis y Frederick Mosteller, entonces los dos en Harvard, usaron el problema en 1989 como punto de partida de un estudio sobre las coincidencias en general. Su conclusión es lo que llamaron la ley de los números verdaderamente grandes (law of truly large numbers): con una muestra suficientemente grande, cualquier cosa extraordinaria acabará ocurriendo. Una coincidencia que tiene una probabilidad de una entre un millón le sucede cada día a ocho mil personas en un mundo de ocho mil millones de habitantes, y es a ellas a las que se entrevista. La mayor parte de las casualidades asombrosas son problemas del cumpleaños mal planteados: se calcula la probabilidad de que le ocurra algo concreto a una persona concreta, cuando la pregunta pertinente es la de que le ocurra algo de ese estilo a alguien. Es el mismo mecanismo que hace peligrosas las comparaciones múltiples en la ciencia.

El caso donde el problema del cumpleaños tiene consecuencias más serias es la criptografía, que lo usa como arma y como medida. Una función hash criptográfica resume cualquier documento en una huella de tamaño fijo, digamos de b bits, y es segura si nadie puede encontrar dos documentos distintos con la misma huella. Buscar un documento que coincida con una huella dada exige probar del orden de 2b2^b documentos, pero encontrar dos cualesquiera que coincidan entre sí solo exige unos 2b/22^{b/2}, exactamente por la misma razón por la que 23 personas bastan con 365 días. Gideon Yuval lo explicó en 1979 con un ejemplo de estafa: se preparan muchas variantes inocentes de un contrato favorable y muchas de uno perjudicial, cambiando comas y espacios, hasta encontrar una de cada tipo con la misma huella; la víctima firma la primera y la firma vale para la segunda. A ese procedimiento se le llama ataque de cumpleaños (birthday attack), y es la razón por la que una huella de 128 bits solo ofrece 64 de seguridad frente a colisiones y las funciones actuales usan 256.

Al final, el problema es un recordatorio de algo que se repite en toda la estadística: el azar produce coincidencias mucho más a menudo de lo que parece, porque las oportunidades de coincidir crecen mucho más deprisa que las cosas que pueden coincidir. En una reunión de treinta personas, apostar a que hay dos que cumplen el mismo día es una apuesta con siete posibilidades de diez a favor, y quien la acepta en contra suele hacerlo convencido de que la ventaja es suya.

Capítulo 3 de 10

El método de Montecarlo

Matemática y estadística 1213 palabras artículo suelto ↗

El método de Montecarlo (en inglés, Monte Carlo method) es la familia de técnicas que calculan una cantidad que no es aleatoria simulando muchas veces un experimento que sí lo es. Si se quiere saber qué fracción de un cuadrado ocupa una figura de forma complicada, en lugar de integrar su contorno se lanzan puntos al azar sobre el cuadrado y se cuenta cuántos caen dentro. Si se quiere saber con qué probabilidad se gana un solitario, en lugar de analizar todas las combinaciones de la baraja se juegan mil partidas y se cuentan las ganadas. La respuesta nunca es exacta, pero su error se conoce de antemano y baja tanto como se quiera a cambio de más simulaciones.

La figura hace el ejemplo clásico. Un cuarto de círculo de radio uno ocupa π/4 del cuadrado de lado uno que lo contiene, así que la fracción de puntos al azar que caen dentro del arco estima π/4, y multiplicarla por cuatro estima π. El segundo método del desplegable es más antiguo y más extraño: se dejan caer agujas sobre un suelo de tablas paralelas, y la proporción de agujas que cruzan una junta, que depende de π aunque en el suelo no haya ningún círculo, permite despejarlo. A la derecha, la gráfica mide el error de la estimación contra el número de intentos, en escala logarítmica, junto a la raya que marca el error típico esperado.

Interactivo Lanza puntos o agujas y mira cómo se acerca la estimación de π. La gráfica de la derecha, en doble escala logarítmica, compara el error real con la raya del error típico, que baja como 1/√n: para ganar una cifra decimal hay que multiplicar los intentos por cien. A partir de unos miles, el lienzo deja de dibujar y solo cuenta.

Lo primero que enseña la figura es que el método funciona. Con cien puntos, π sale casi siempre entre 2,8 y 3,5; con diez mil, entre 3,11 y 3,17 casi siempre; con doscientos mil, la segunda cifra decimal ya es de fiar. Lo segundo es lo lento que es. La raya discontinua de la gráfica tiene pendiente −1/2, porque el error típico de una proporción estimada con n intentos es proporcional a 1/√n, como explica la ley de los grandes números. Dividir el error por diez exige multiplicar los intentos por cien, y conseguir las diez cifras de π que cualquier calculadora da al instante exigiría del orden de 10²¹ puntos. Como forma de calcular π, el método de Montecarlo es malo.

La aguja tiene una historia más larga que el método. Georges-Louis Leclerc, conde de Buffon, planteó en 1733 la pregunta de con qué probabilidad una aguja lanzada sobre un entarimado cae sobre una de las juntas, y publicó la solución en 1777 en su Ensayo de aritmética moral: si la aguja es tan larga como la anchura de las tablas, la probabilidad es 2/π. Pierre-Simon Laplace señaló en 1812 que la fórmula podía usarse al revés, para medir π tirando agujas, y en el siglo XIX hubo quien lo hizo. El caso más famoso es el del matemático italiano Mario Lazzarini, que en 1901 dijo haber lanzado 3.408 agujas y obtenido 355/113, es decir, 3,1415929, un valor correcto en seis decimales. Lee Badger mostró en 1994 que el resultado era demasiado bueno para ser cierto: con ese número de lanzamientos, la precisión esperable es de una o dos cifras, y 3.408 es justo uno de los pocos tamaños que permiten llegar a 355/113 con números enteros, lo que indica que Lazzarini se detuvo cuando le salió la fracción que buscaba, o que eligió de antemano cuántas agujas decir que había tirado.

El método moderno nació de un solitario. En 1946, el matemático polaco Stanislaw Ulam convalecía de una encefalitis y pasaba el tiempo jugando al Canfield, una variante de solitario, cuando se preguntó qué probabilidad había de ganar una partida. Después de intentar calcularla por combinatoria, pensó que sería más práctico jugar cien partidas y contar las ganadas, y que ese mismo razonamiento valía para el problema en el que trabajaba en Los Álamos: la difusión de los neutrones en el material fisionable, donde cada neutrón choca, se desvía, se absorbe o provoca una fisión según probabilidades conocidas, y donde el comportamiento de conjunto era imposible de calcular con ecuaciones. Se lo contó a John von Neumann, que vio que el recién construido ENIAC podía seguir miles de historias de neutrones una a una, y las primeras simulaciones se ejecutaron en la primavera de 1948. El nombre en clave lo propuso Nicholas Metropolis, recordando a un tío de Ulam que pedía dinero prestado a la familia porque tenía que ir a Montecarlo, y apareció impreso por primera vez en el artículo que Metropolis y Ulam publicaron en 1949.

Hubo precedentes que no llevaban ese nombre. Enrico Fermi usaba muestreo aleatorio en Roma en los años treinta para estimar el recorrido de los neutrones, con una calculadora mecánica y sin publicarlo, y William Gosset, que firmaba como «Student», comprobó en 1908 su distribución t sacando al azar muestras de las medidas de tres mil presos escritas en tarjetas. Lo que cambió después de la guerra fue que por primera vez había una máquina capaz de repetir el experimento el número de veces que el error de 1/√n exige. El problema pasó a ser de dónde sacar tanto azar. La RAND Corporation publicó en 1955 un libro entero, A Million Random Digits with 100,000 Normal Deviates, generado con una ruleta electrónica, y enseguida se impusieron los números pseudoaleatorios, secuencias deterministas que pasan todas las pruebas de azar que se les hacen.

Si el método es tan lento, ¿por qué se usa? Porque su error no depende de cuántas dimensiones tenga el problema. Calcular el área de una figura plana con una cuadrícula de cien divisiones por lado exige diez mil evaluaciones; hacer lo mismo con un volumen en diez dimensiones, que es lo que pasa al integrar sobre las posiciones de diez partículas o sobre diez variables financieras, exige 100¹⁰, un uno seguido de veinte ceros. El método de Montecarlo, en cambio, necesita el mismo número de puntos para el mismo error en dos dimensiones que en mil, porque lo único que cuenta es qué fracción cae dentro. En los problemas con muchas variables, que son casi todos los de verdad, no es el método lento: es el único.

En 1953, Metropolis, con Arianna y Marshall Rosenbluth y Augusta y Edward Teller, dio el paso siguiente: en lugar de lanzar puntos independientes, construir una cadena en la que cada punto se propone a partir del anterior y se acepta o se rechaza según una regla, de modo que la cadena pase más tiempo donde la probabilidad es mayor. Ese algoritmo de Metropolis, generalizado en 1970 por W. Keith Hastings, es el motor de la estadística bayesiana moderna, que durante dos siglos había sido una teoría elegante sin forma práctica de calcular sus resultados. Hoy la familia de Montecarlo valora opciones financieras simulando miles de trayectorias de precios, calcula la luz de las películas de animación siguiendo rayos que rebotan al azar entre las superficies, estima el riesgo de las centrales nucleares y guía la búsqueda de los programas que juegan al go, que exploran jugadas prometedoras simulando partidas hasta el final. En todos los casos se paga el mismo precio y se obtiene la misma ventaja que en la figura: cada cifra de precisión cuesta cien veces más, pero la cuenta no se complica cuando el problema lo hace.

Capítulo 4 de 10

El teorema central del límite

Matemática y estadística 1086 palabras artículo suelto ↗

El teorema central del límite afirma que, si se toman muchas muestras del mismo tamaño de una población cualquiera y se calcula la media de cada una, esas medias se distribuyen aproximadamente como una campana de Gauss, con independencia de la forma que tuviera la población de partida. La aproximación mejora al crecer el tamaño de la muestra, y la anchura de la campana se estrecha en proporción a la raíz cuadrada de ese tamaño. Es el resultado que permite que casi toda la estadística aplicada funcione: intervalos de confianza, contrastes de hipótesis y márgenes de error de las encuestas descansan en él, y por eso se le llama central, en el sentido de «que ocupa el centro», no en el de que hable de centros.

La afirmación es menos intuitiva de lo que parece cuando se enuncia en abstracto, y por eso conviene verla ocurrir. En la figura se elige una población deliberadamente poco gaussiana —una exponencial, con toda su masa pegada al cero y una cola larga a la derecha; una distribución con dos picos y nada en medio; un dado, que solo puede dar seis valores— y se extraen de ella muestras del tamaño que se quiera. Cada muestra aparece como una hilera de puntos sobre la población, su media se marca en naranja, y esa media cae al histograma de abajo. Con una sola muestra el histograma no dice nada. Con cien empieza a insinuarse una forma. Con mil, la campana está ahí, centrada exactamente en la media de la población, aunque la población no se le parezca en nada.

Interactivo Elige la población de arriba y el tamaño de muestra. Cada muestra deja su media en el histograma de abajo; la curva a trazos es la normal que predice el teorema, con desviación σ/√n. Prueba con n = 1 para ver que sin promediar no hay campana, y con n = 30 para ver por qué ese número se convirtió en regla.

Dos cosas se aprecian en el simulador que la fórmula esconde. La primera es que con tamaño de muestra 1 no ocurre nada: las «medias» son los propios valores, y el histograma reproduce la forma de la población, sesgo incluido. La campana no está en los datos, está en el promedio. La segunda es que la velocidad a la que aparece depende de lo asimétrica que sea la población de partida. Con la uniforme, cinco valores por muestra bastan para que la forma sea razonablemente gaussiana; con la exponencial hacen falta veinte o treinta, y con una renta de cola muy larga la cola derecha del histograma sigue siendo visible bastante después. La regla práctica que enseñan los manuales —«a partir de treinta observaciones se puede suponer normalidad»— no es un teorema sino una observación empírica sobre poblaciones moderadamente sesgadas, y el simulador permite ver dónde falla.

La historia del resultado es larga porque tardó en enunciarse con generalidad. Abraham de Moivre publicó en 1733 que el número de caras al lanzar muchas monedas se aproxima con la curva que hoy llamamos normal; era un caso particular, el de sumar variables que solo valen cero o uno. Pierre-Simon Laplace extendió el argumento en 1810 a sumas de variables de casi cualquier tipo y lo aplicó a los errores de medida astronómicos, que era el problema que le interesaba: si cada observación de un planeta arrastra un error compuesto de muchas causas pequeñas e independientes, la suma de esas causas es aproximadamente normal, y por tanto el error también. Las demostraciones rigurosas, con condiciones explícitas sobre las variables, llegaron con Aleksandr Liapunov en 1901 y con Jarl Lindeberg y Paul Lévy en los años veinte. El nombre lo puso George Pólya en 1920, en un artículo escrito en alemán, y su elección del adjetivo zentral se refería a la posición del teorema dentro de la teoría de la probabilidad.

El enunciado moderno tiene tres condiciones y conviene conocerlas porque cada una puede fallar en la práctica. Las observaciones tienen que ser independientes, o al menos no demasiado dependientes; deben proceder de la misma distribución, o de distribuciones parecidas; y esa distribución debe tener varianza finita. La tercera es la que más sorprende: existen distribuciones, como la de Cauchy, cuya cola es tan pesada que ni siquiera tienen media definida, y para ellas el teorema simplemente no se cumple. La media de mil observaciones de Cauchy es tan errática como una sola. En economía y finanzas, donde los rendimientos extremos son más frecuentes de lo que una normal admitiría, esta condición es motivo de discusión permanente desde que Benoit Mandelbrot la planteó en los años sesenta.

El teorema también dice cuánto se estrecha la campana, y ese detalle es el que sostiene las encuestas. La desviación típica de las medias muestrales es la de la población dividida por la raíz cuadrada del tamaño de muestra. Para reducir el error a la mitad hay que cuadruplicar la muestra; para reducirlo a la décima parte, multiplicarla por cien. Es la razón de que un sondeo de mil personas tenga un margen de error de unos tres puntos y de que pasar a diez mil personas solo lo baje a uno: el rendimiento decreciente está escrito en la raíz cuadrada. En la figura, al aumentar el tamaño de muestra de 5 a 20 el histograma se estrecha justo a la mitad, y la lectura compara la dispersión observada con la que predice la fórmula.

Andrew Berry en 1941 y Carl-Gustav Esseen en 1942 respondieron, por separado, a la pregunta natural de cómo de buena es la aproximación para un tamaño de muestra dado. Su cota dice que la distancia máxima entre la distribución real de la media y la normal está acotada por una constante multiplicada por una medida de la asimetría de la población y dividida por la raíz del tamaño de muestra. Es el enunciado preciso de lo que el simulador muestra a ojo: la campana llega antes cuanto más simétrica sea la población y cuanto mayor sea la muestra, y la relación entre ambas cosas es exactamente la raíz cuadrada.

Lo que el teorema no dice es igualmente importante. No afirma que los datos individuales de ninguna población sean normales, ni que muchos fenómenos naturales lo sean; afirma algo sobre los promedios de muestras. Las alturas humanas se aproximan a una normal porque cada altura es, en efecto, la suma de muchas contribuciones pequeñas, pero las rentas, los tamaños de las ciudades o la frecuencia de las palabras no lo son ni lo serán por mucho que se mida. Confundir «las medias de las muestras son normales» con «los datos son normales» es un error frecuente, y el simulador lo desmonta con solo mirar las dos gráficas a la vez: la de arriba, la población, no cambia nunca de forma; la de abajo, las medias, se vuelve campana sea cual sea la de arriba.

Capítulo 5 de 10

El intervalo de confianza

Matemática y estadística 947 palabras artículo suelto ↗

El intervalo de confianza es un rango de valores calculado a partir de una muestra con un procedimiento que, repetido muchas veces sobre muestras distintas de la misma población, produce rangos que contienen el valor real de la población en un porcentaje conocido de los casos. Ese porcentaje es el nivel de confianza, habitualmente el 95 %, y la definición está enunciada a propósito en términos del procedimiento y no del resultado. La formuló Jerzy Neyman en 1937 y su cuidado en la redacción no es un tecnicismo: es lo único que distingue el intervalo de confianza de lo que casi todo el mundo cree que significa.

Retrato fotográfico de Karl Pearson, de mayor, con barba blanca y gafas
Fig. 1 Karl Pearson en 1910. El intervalo de confianza nació en la escuela estadística londinense que él construyó en el University College: Jerzy Neyman la formuló en 1937 en esa institución, en el marco de los contrastes que desarrolló con el hijo de Pearson, Egon. El intervalo cuantifica solo el error de muestreo, y la experiencia de las encuestas electorales muestra que ese es apenas la mitad del error real.Autoría desconocida · 1910 · Dominio público · Wikimedia Commons

Lo que la gente entiende al leer que un intervalo del 95 % va de 38 a 44 es que hay un 95 % de probabilidad de que el valor verdadero esté entre 38 y 44. Esa frase es incorrecta dentro del marco en el que el intervalo se calcula. En la estadística frecuentista, el parámetro de la población es una cantidad fija y desconocida, no una variable aleatoria: no tiene sentido asignarle una probabilidad de estar en ningún sitio. Lo aleatorio es la muestra, y por tanto lo aleatorio es el intervalo. Una vez calculado un intervalo concreto, ese intervalo contiene el valor o no lo contiene, y no hay ninguna probabilidad intermedia. El 95 % describe el comportamiento del método a lo largo de muchas repeticiones, no la credibilidad de un resultado particular. Quien quiera una afirmación probabilística sobre el parámetro tiene que salir del marco y calcular un intervalo de credibilidad bayesiano, que exige declarar una distribución previa y que, en muchos casos con muestras grandes, sale numéricamente parecido pero significa otra cosa.

Que la confusión es la regla y no la excepción está medido. Rink Hoekstra y sus colaboradores presentaron en 2014 a ciento veinte investigadores y cuatrocientos cuarenta y dos estudiantes de psicología un resultado con su intervalo de confianza y seis afirmaciones sobre él, todas falsas, y les pidieron marcar las que consideraran correctas. Los estudiantes de primer año marcaron una media de 3,5 afirmaciones falsas; los investigadores con experiencia, 3,4. No hubo mejora con la formación. Sander Greenland y un grupo de veinticuatro estadísticos y epidemiólogos publicaron en 2016 un inventario de veinticinco malinterpretaciones habituales del valor p, los intervalos y la potencia, y entre ellas figuran las dos que más se ven en la prensa: creer que un valor fuera del intervalo queda descartado, y creer que dos intervalos que se solapan indican que no hay diferencia.

La segunda cosa que el intervalo no dice es más importante para leer una encuesta, y es la que arruina el uso periodístico del «margen de error». El intervalo de confianza solo cuantifica una fuente de incertidumbre: el error de muestreo, es decir, la variabilidad que resulta de haber preguntado a mil personas y no a todas. No cuantifica el sesgo. Si la muestra no representa a la población —porque quien contesta al teléfono no es como quien no contesta, porque el marco de la muestra excluye a una parte del país, porque la pregunta está mal redactada, porque el modelo de ponderación reparte mal los pesos—, el intervalo se calcula igual, sale igual de estrecho y está centrado en el sitio equivocado. Un error de muestreo pequeño alrededor de una estimación sesgada produce exactamente la falsa sensación de precisión que la cifra pretende evitar.

La magnitud de ese hueco se ha estimado. Houshmand Shirani-Mehr, David Rothschild, Sharad Goel y Andrew Gelman analizaron en 2018 cuatro mil doscientas veintiuna encuestas de elecciones estadounidenses de gobernador, senador y presidente entre 1998 y 2014, y compararon las estimaciones con los resultados. El error medio real fue de unos tres puntos y medio, prácticamente el doble del error de muestreo que las encuestas declaraban; y solo alrededor del 60 % de sus intervalos del 95 % contenía el resultado, cuando por definición del método debería haberlo hecho el 95 %. La conclusión de los autores es que un intervalo honesto para una encuesta electoral tendría que ser aproximadamente el doble de ancho del que se publica, porque el resto lo aporta el sesgo y no la aritmética.

De ahí se sigue una manera correcta de leer los intervalos que aparecen en las noticias, y son tres reglas. La primera: la anchura del intervalo informa de la precisión del procedimiento, y si un intervalo es muy ancho la conclusión honrada es que el estudio no permite decidir, no que el efecto sea cero. La segunda: la diferencia entre dos grupos necesita su propio intervalo, y no se puede deducir comparando a ojo si los intervalos de cada grupo se solapan; ese atajo produce falsos negativos con mucha frecuencia. La tercera: el intervalo solo es tan bueno como el diseño del muestreo que lo sostiene, y cuando lo que falla es el diseño, el intervalo no avisa.

Conviene añadir la objeción que la propia comunidad estadística ha ido aceptando. Durante décadas se recomendó sustituir el contraste de hipótesis por intervalos de confianza, con el argumento de que el intervalo informa del tamaño del efecto y de su precisión mientras el valor p solo produce un veredicto. La recomendación sigue siendo buena, pero no resuelve el problema que decía resolver: en la práctica, un intervalo se lee comprobando si contiene el cero, es decir, se convierte en un contraste de hipótesis con otra tipografía. La ganancia de los intervalos es real solo si quien los lee atiende a los dos extremos y se pregunta si el valor más pequeño compatible con los datos sería importante y si el más grande sería creíble. Sin esa lectura, el intervalo es una prueba de significación disfrazada de estimación.

Capítulo 6 de 10

El bootstrap

Matemática y estadística 1229 palabras artículo suelto ↗

El bootstrap (la palabra se usa tal cual en español, y a veces se traduce por remuestreo) es una manera de medir cuánto se puede fiar uno de una cifra calculada a partir de una muestra, usando solo la propia muestra. La idea es sacar de ella, al azar y con reposición, muchas muestras nuevas del mismo tamaño, calcular la cifra en cada una y mirar cuánto varía. Esa variación imita la que se vería si se pudiera volver a muestrear la población una y otra vez, que es precisamente lo que no se puede hacer. El nombre viene de la expresión inglesa to pull oneself up by one’s bootstraps, levantarse tirando de los cordones de las propias botas, que se suele asociar con el barón de Münchhausen, aunque en el libro él se saca del pantano tirando de su propia coleta, y que describe algo que parece imposible: sacar información sobre la incertidumbre de unos datos sin más material que esos mismos datos.

La figura usa el ejemplo con el que Bradley Efron y Robert Tibshirani enseñan el método en su manual de 1993. Son quince facultades de derecho de Estados Unidos, elegidas al azar entre las ochenta y dos que participaron en un estudio sobre admisiones, con dos notas por facultad: la media de su examen de acceso, el LSAT, y la media de las calificaciones del grado de sus alumnos, el GPA. La correlación entre las dos es de 0,776, y la pregunta es cuánto habría cambiado si el azar hubiera elegido otras quince.

Interactivo Cada remuestra saca quince facultades de las quince originales, con reposición: unas entran dos o tres veces (el círculo naranja crece) y otras ninguna (quedan punteadas). El histograma recoge el estadístico en cada remuestra; su dispersión es la estimación bootstrap del error típico, y el 95 % central, sombreado, un intervalo de confianza. Con la mediana el histograma sale a saltos, porque solo puede tomar unos pocos valores.

Al pulsar «Una remuestra» se ve el mecanismo. Se sacan quince facultades de la bolsa de quince, devolviendo cada una a la bolsa antes de sacar la siguiente, de modo que algunas salen repetidas y otras no salen. Por término medio, cada remuestra deja fuera algo más de un tercio de los datos originales y ocupa ese hueco con repeticiones. Con cada remuestra se calcula de nuevo la correlación, que sale 0,69, 0,85, 0,61, y el histograma va recogiendo esos valores. Con mil remuestras, su desviación típica anda por 0,13, y esa cifra es el error típico de la correlación según el bootstrap. El intervalo que deja fuera el 2,5 por ciento más bajo y el 2,5 por ciento más alto va aproximadamente de 0,46 a 0,96, y es un intervalo de confianza al 95 por ciento conseguido sin una sola fórmula.

Hay una razón para que sea tan útil precisamente con la correlación. Para la media existe una fórmula sencilla del error típico, la desviación típica dividida por la raíz de n, y el bootstrap se limita a reproducirla, como se ve eligiendo la media en el desplegable. Para la correlación, la fórmula clásica supone que los datos siguen una distribución normal en dos dimensiones, y con quince datos nadie puede comprobarlo. Para la mediana, la fórmula existe pero depende de la densidad de la población justo en el centro, que tampoco se conoce. Y para cosas como el cociente entre dos medianas, el coeficiente de una regresión robusta o la precisión de un modelo de aprendizaje automático medida sobre un conjunto de prueba, no hay fórmula que valga. El bootstrap trata a todas igual: se calcula la cifra, se remuestrea, se vuelve a calcular. Lo que antes exigía una derivación matemática para cada estadístico pasa a exigir solo tiempo de ordenador.

La razón por la que funciona es que la muestra, si se ha tomado al azar, es la mejor estimación disponible de la población. Remuestrear la muestra equivale a tratarla como si fuera la población y a preguntarse qué pasaría si de esa población se sacaran muestras de quince. Si la muestra se parece a la población, la variación entre remuestras se parece a la variación entre muestras. La justificación rigurosa, que Efron dio en 1979 y que se afinó durante la década siguiente, demuestra que para una clase amplia de estadísticos la aproximación mejora al crecer la muestra, y que en algunos casos es incluso más precisa que la aproximación normal clásica.

El método tenía un antecedente. En 1949, Maurice Quenouille propuso corregir el sesgo de un estimador recalculándolo quitando cada vez un dato, y en 1958 John Tukey convirtió esa idea en un método para estimar errores típicos y le puso nombre de herramienta: la navaja (jackknife), por ser algo tosco que sirve para casi todo. Efron presentó el bootstrap en 1979, en un artículo de The Annals of Statistics cuyo subtítulo, otra mirada a la navaja, reconocía la deuda, y demostró que la navaja era una aproximación lineal al bootstrap. El método tardó en imponerse porque exigía una potencia de cálculo que a finales de los setenta no estaba al alcance de cualquiera: mil remuestras de un conjunto de datos mediano eran una noche entera de ordenador central. Con los ordenadores personales se volvió trivial, y en 2019 Efron recibió por él el Premio Internacional de Estadística, que se concede cada dos años a una contribución que haya cambiado la disciplina.

El bootstrap no es una varita mágica, y hay casos en los que falla de manera instructiva. El más claro es el máximo. Si se quiere estimar el valor más alto posible de una población a partir del mayor valor observado, el bootstrap no sirve, porque ninguna remuestra puede producir un máximo mayor que el de la muestra, y alrededor de un 63 por ciento de las remuestras lo repiten exactamente. El histograma sale con una barra enorme en el máximo observado y nada a su derecha, que es justo donde está la verdad. Para ese problema hay métodos propios, que el problema del tanque alemán resolvió en la Segunda Guerra Mundial. El segundo fallo son las muestras diminutas: con cinco datos, la muestra se parece poco a la población y las remuestras heredan todos sus defectos. El tercero es la dependencia. Si los datos son una serie temporal, como las temperaturas diarias o los precios de una acción, cada observación se parece a la anterior, y remuestrearlas por separado destruye esa estructura. Hans Künsch propuso en 1989 remuestrear bloques de observaciones consecutivas en lugar de observaciones sueltas, y esa variante, el block bootstrap, es la que se usa en econometría y en climatología.

Hoy el bootstrap es el método por defecto para poner márgenes de error a cualquier cosa que no tenga una fórmula conocida. Se usa para los intervalos de los árboles filogenéticos, donde cada rama lleva el porcentaje de remuestras en que aparece; para medir la estabilidad de un agrupamiento; y, cada vez más, para comparar modelos de inteligencia artificial, donde la pregunta de si un sistema que acierta el 71 por ciento de un examen es de verdad mejor que otro que acierta el 69 se responde remuestreando las preguntas del examen, como explica el artículo sobre el ruido en una evaluación. También los bosques aleatorios de aprendizaje automático son bootstrap: cada árbol se entrena con una remuestra distinta de los datos, y la variedad que eso produce es lo que hace que el conjunto se equivoque menos que cualquiera de sus árboles. Lo que Efron cambió no fue solo una técnica, sino la relación de la estadística con el cálculo: donde antes había que suponer una distribución para poder derivar una fórmula, ahora basta con simular lo que habría pasado.

Capítulo 7 de 10

El problema del tanque alemán

Matemática y estadística 1213 palabras artículo suelto ↗

El problema del tanque alemán (en inglés, German tank problem) es el de estimar cuántos objetos numerados existen a partir de los números de serie de unos pocos de ellos. Si una fábrica numera sus tanques del uno en adelante y se capturan cinco con los números 19, 40, 42, 60 y 72, ¿cuántos ha fabricado? El nombre viene de la Segunda Guerra Mundial, cuando los estadísticos aliados lo resolvieron para calcular la producción alemana de carros de combate, y acertaron donde el espionaje convencional se equivocaba por un factor de casi cinco.

La figura plantea el problema con una fábrica cuya producción se oculta hasta que se pide verla. Arriba aparecen los números de serie capturados sobre una recta; debajo, lo que estiman tres métodos distintos. El botón de repetir hace dos mil capturas del mismo tamaño y dibuja cómo se reparten las estimaciones de cada método, que es la manera de saber cuál es mejor sin depender de la suerte de una sola captura. La fábrica de partida tiene la producción alemana real de agosto de 1942.

Interactivo Captura unos cuantos tanques y compara tres estimaciones de la producción: el mayor número visto, dos veces la media de los números y la fórmula m + m/k − 1. Al repetir la captura dos mil veces, la del mayor número se queda siempre corta, la de la media se reparte mucho más ancha y la fórmula cae centrada en la producción real con la menor dispersión de las tres.

El método más ingenuo es tomar el mayor número visto. Tiene la virtud de no pasarse nunca, y el defecto de quedarse siempre corto: el tanque con el número más alto de la fábrica solo se habrá capturado por casualidad. El segundo método razona sobre la media. Si los números van del uno al N y la captura es al azar, su media debería estar hacia la mitad, en torno a N/2, así que el doble de la media estima N. El razonamiento es correcto y el estimador no tiene sesgo, pero desperdicia información, y a veces da un resultado absurdo: con los números 19, 40, 42, 60 y 72, la media es 46,6 y la estimación sale 92, que es posible; pero si se hubieran capturado el 5, el 8, el 11 y el 90, la estimación sería 56, menos que el 90 que se tiene delante.

El tercer método se fija solo en el mayor número, al que llamaremos m, y en cuántos tanques se han capturado, k. La idea es que los k números capturados parten el intervalo entre cero y N en k + 1 huecos que, por término medio, miden lo mismo. Los huecos por debajo de m se ven, y miden en promedio m/k; el hueco por encima de m, que no se ve, debería medir más o menos lo mismo. La estimación es entonces el mayor visto más un hueco medio:

N^=m+mk−1 \hat{N} = m + \frac{m}{k} - 1

Con los cinco tanques del ejemplo, m es 72 y la estimación, 72 + 72/5 − 1, que redondeada es 85. Se puede demostrar que este estimador es insesgado y que, entre todos los insesgados, es el de menor varianza, que es la definición técnica de ser el mejor posible. La figura lo enseña sin demostración: tras repetir la captura, la curva del mayor visto queda toda a la izquierda de la producción real, la del doble de la media se centra bien pero se reparte bastante más ancha, y la de la fórmula se centra y se estrecha a la vez.

La historia real es la que ha hecho famoso el problema. Durante la guerra, la División de Guerra Económica de la embajada de Estados Unidos en Londres empezó a reunir los números de serie de todo el material alemán capturado o destruido: chasis, motores, cajas de cambios y, sobre todo, ruedas. Los tanques Panther llevaban las ruedas de rodadura fundidas en moldes numerados, y el análisis de las ruedas de dos tanques capturados permitió estimar cuántos moldes usaba la fábrica y, a partir de ahí, su ritmo de producción. Richard Ruggles y Henry Brodie, dos de los economistas que hicieron el trabajo, lo publicaron en 1947, y compararon sus estimaciones con los registros del ministerio de Albert Speer, que se habían capturado después de la guerra. Para el Panther, las ruedas decían 270 tanques en febrero de 1944, y Speer había anotado 276.

La comparación que se suele citar es la de la producción mensual de tanques en general. Para junio de 1940, la estimación estadística fue de 169 al mes, los servicios de inteligencia calculaban unos 1.000 y los registros alemanes dijeron 122. Para junio de 1941, la estadística dijo 244, la inteligencia 1.550 y los registros 271. Para agosto de 1942, 327, 1.550 y 342. Los informes de inteligencia, basados en interrogatorios, fotografías aéreas y agentes, sumaban cifras de fuentes que se solapaban, y el error iba siempre en la misma dirección: hacia arriba. Los números de serie, en cambio, eran datos que los alemanes no tenían ninguna razón para falsear, porque nadie en la fábrica pensaba que fueran a servir para nada fuera de ella. La estimación estadística se equivocó en todos los casos, pero por unas decenas de tanques y no por más de mil.

El método que se usó no era exactamente la fórmula de la figura. Los números de serie reales no empezaban siempre en uno, se asignaban por bloques a fábricas distintas y tenían huecos, y buena parte del trabajo consistió en reconstruir el sistema de numeración antes de poder contar. La fórmula de mínima varianza la dejó bien establecida Leo Goodman en 1952, en un artículo que trataba el caso general con números que no empiezan en uno, y el problema pasó a los manuales como ejemplo de estimación. En los años noventa entró en las aulas como ejercicio práctico, con alumnos que sacan papelitos numerados de una bolsa e inventan sus propios estimadores antes de compararlos, y es habitual que alguno proponga el doble de la media y otro el mayor visto antes de llegar a la solución.

La misma lógica ha servido para contar muchas otras cosas. En la guerra se aplicó también a otros equipos capturados, y después de ella se ha usado, por ejemplo, para estimar las ventas de un aparato electrónico a partir de los números de serie que sus compradores publicaban en internet, cuando el fabricante no daba la cifra. Tiene el mismo aire de familia que otros métodos que cuentan lo que no se ve a partir de lo que se ve, como la captura y recaptura con que los ecólogos estiman cuántos peces hay en un lago marcando unos cuantos, soltándolos y contando cuántos marcados aparecen en una segunda pesca.

El problema es también un buen ejemplo de un caso en el que los métodos generales fallan. El bootstrap, que sirve para medir la incertidumbre de casi cualquier cifra, no sirve para el máximo, porque ninguna remuestra puede producir un número mayor que el más alto capturado, y justo lo que interesa aquí es lo que hay por encima. Hace falta pensar el problema desde su estructura, que es lo que hicieron los economistas de Londres: los números de serie no son una muestra de cualquier cosa, sino de una secuencia que empieza en un punto y termina en otro, y el final es exactamente lo que se quiere conocer. Estimar bien exige saber qué sesgo tiene cada manera de calcular antes de elegir una, y el mayor número visto, que parece la respuesta más prudente porque nunca se pasa, es la única de las tres que se equivoca siempre en la misma dirección.

Capítulo 8 de 10

El valor p y la significación estadística

Matemática y estadística 980 palabras artículo suelto ↗

El valor p es la probabilidad de obtener un resultado al menos tan extremo como el observado suponiendo que la hipótesis nula sea cierta y que el modelo estadístico empleado sea correcto. Cuando ese número queda por debajo de un umbral convenido —tradicionalmente 0,05— el resultado se declara estadísticamente significativo. La definición contiene dos condicionales que son los que se pierden en cada resumen periodístico, y de esa pérdida sale casi todo lo que se hace mal con la cifra.

Lo primero que hay que quitar de la cabeza es la lectura invertida. El valor p es la probabilidad de los datos dada la hipótesis, no la probabilidad de la hipótesis dados los datos. Un p de 0,03 no significa que haya un 3 % de probabilidad de que el resultado sea casualidad, ni un 97 % de que el efecto exista. Tampoco mide la importancia del efecto: con una muestra suficientemente grande, una diferencia irrelevante para cualquier propósito práctico produce valores p diminutos, y con una muestra pequeña un efecto grande y real puede quedarse en 0,2. Y un valor p por encima del umbral no demuestra que no haya efecto; demuestra que estos datos no bastan para distinguirlo del ruido, que es una afirmación mucho más modesta.

El umbral de 0,05 no tiene ninguna base teórica. Lo propuso Ronald Fisher en 1925 como una convención de conveniencia —observó que un desvío de dos veces la desviación típica es un punto cómodo para juzgar si un resultado merece atención— y él mismo entendía el valor p como una medida continua de evidencia dentro de un programa de experimentación repetida, no como un botón de aprobación. La conversión del criterio en un umbral binario y en un requisito de publicación vino después, con la fusión práctica del enfoque de Fisher y el contraste de hipótesis de Neyman y Pearson, y produjo el incentivo que ha marcado un siglo de literatura científica: los resultados por debajo de 0,05 se publican y los demás se quedan en el cajón.

Retrato fotográfico de William Sealy Gosset, con traje oscuro y gafas
Fig. 1 William Sealy Gosset en 1908. Firmando como «Student» desde la fábrica de Guinness, publicó la distribución t que hace posible juzgar la significación con muestras pequeñas; Fisher, que conocía su trabajo, convirtió ese criterio en el valor p de 1925. La conversión de una medida continua de evidencia en un umbral binario vino después, con la fusión práctica de los enfoques de Fisher y de Neyman y Pearson.User Wujaszek on pl.wikipedia · 2016 · Dominio público · Wikimedia Commons

Ese incentivo tiene consecuencias medibles. John Ioannidis argumentó en 2005, con un modelo explícito, que en campos con muchas hipótesis exploradas, muestras pequeñas y efectos reales pequeños, la mayor parte de los hallazgos publicados como significativos tienen que ser falsos, porque la probabilidad de que una hipótesis sea verdadera antes del estudio es baja y el umbral admite un 5 % de falsos positivos por cada hipótesis probada. Joseph Simmons, Leif Nelson y Uri Simonsohn lo demostraron por construcción en 2011: mostraron que con la flexibilidad no declarada que cualquier investigador tiene a mano —decidir cuándo parar de recoger datos, elegir entre dos variables dependientes, incluir o no una covariable, excluir observaciones atípicas— la probabilidad de obtener un resultado significativo a partir de datos sin ninguna señal sube del 5 % a más del 60 %. A esa práctica, que rara vez es un fraude deliberado y casi siempre una serie de decisiones razonables tomadas después de ver los datos, se le llama p-hacking.

La comprobación empírica llegó en 2015, cuando la Open Science Collaboration replicó cien estudios publicados en tres revistas de psicología de primer nivel con protocolos acordados de antemano y muestras mayores que las originales. De los noventa y siete que habían informado de resultados significativos, treinta y cinco volvieron a serlo, y el tamaño medio de los efectos replicados fue aproximadamente la mitad del original. Resultados semejantes aparecieron después en economía experimental y en biología del cáncer. La discusión sobre la magnitud exacta de la crisis de replicación sigue abierta —hay quien defiende que una parte del fallo se explica por diferencias de contexto entre el estudio original y la réplica—, pero el hecho de que el umbral de significación no protege de los falsos positivos con la eficacia que se le atribuía ya no se discute.

En 2016, la American Statistical Association hizo algo insólito para una sociedad científica: publicó una declaración formal sobre un procedimiento estadístico. Seis principios, y ninguno de ellos técnico. Que los valores p no miden la probabilidad de que la hipótesis estudiada sea cierta. Que no deben ser la base de decisiones científicas o de política tomadas por un umbral. Que un valor p sin contexto ni otras evidencias aporta información limitada. Que la inferencia adecuada exige informar de todo el proceso —cuántas hipótesis se probaron, qué decisiones de análisis se tomaron— porque sin eso el número no es interpretable. Y que la significación estadística no equivale a importancia. Tres años después, un comentario en Nature firmado por Valentin Amrhein, Sander Greenland y Blake McShane y respaldado por más de ochocientos firmantes pidió abandonar el concepto de significación estadística; la revista Basic and Applied Social Psychology había ido más lejos en 2015 prohibiendo directamente los valores p en sus artículos.

Conviene, sin embargo, no quedarse con la moraleja de que el valor p es una superstición que hay que retirar, porque las alternativas tienen sus propios problemas. Sustituirlo por umbrales más exigentes —se ha propuesto 0,005— reduce los falsos positivos a costa de exigir muestras mucho mayores y de dejar fuera campos donde eso es imposible. Sustituirlo por intervalos de confianza no cambia nada si el intervalo se lee comprobando si contiene el cero, que es lo que ocurre en la práctica. Sustituirlo por factores de Bayes obliga a declarar una distribución previa que otro investigador puede discutir. La crítica sólida del valor p no es que la fórmula esté mal, es que un número que resume la compatibilidad de unos datos con un modelo se estaba usando para tomar una decisión dicotómica sobre la existencia de un fenómeno. Lo que la estadística ha ido concluyendo desde 2005 es que ninguna cifra individual puede hacer ese trabajo, y que lo que lo hace es el tamaño del efecto, la preinscripción del análisis, la publicación de los resultados nulos y la réplica.

Capítulo 9 de 10

La potencia estadística

Matemática y estadística 1204 palabras artículo suelto ↗

La potencia estadística (en inglés, statistical power) es la probabilidad de que un estudio detecte un efecto que existe de verdad. Si un fármaco reduce la tensión arterial y se prueba en un ensayo, la potencia es la probabilidad de que el ensayo salga estadísticamente significativo, y su complemento es la probabilidad de que el efecto real pase inadvertido. Depende de tres cosas: el tamaño del efecto, el número de personas estudiadas y el umbral de significación que se haya elegido. Un efecto grande se ve con pocos datos; uno pequeño exige muchos, y con pocos, el estudio es una moneda al aire que además, como se verá, cuando sale cara engaña.

La figura muestra de dónde sale la cifra. Un estudio compara dos grupos y mide la diferencia entre sus medias en desviaciones típicas, que es lo que se llama tamaño del efecto d. Si el efecto no existe, la diferencia que mediría el estudio se reparte según la campana gris, centrada en cero; si existe, según la naranja, centrada en el valor real. Las rayas verticales son los umbrales de significación, y todo lo que cae más allá se declara significativo. El área gris fuera de los umbrales es α, la probabilidad de una falsa alarma. El área naranja más allá del umbral es la potencia.

Interactivo Mueve el efecto real y el número de personas por grupo. Con los valores de partida, un efecto de 0,3 y treinta personas por grupo, la potencia es del 21 %, la mediana que Button y sus coautores estimaron para la neurociencia en 2013. Al pulsar «Hacer 200 estudios», los significativos salen en naranja, y la raya naranja marca su efecto medio: con poca potencia, el doble del real o más.

Las dos curvas se estrechan al aumentar la muestra, porque el error típico de la diferencia baja con la raíz del número de personas. Con curvas estrechas se separan, la naranja deja casi toda su área más allá del umbral y la potencia se acerca a uno. Con curvas anchas se solapan, y buena parte de los estudios de un efecto real cae en la zona donde no se distingue del ruido. El cálculo al revés da el tamaño de muestra necesario. Para detectar con un 80 por ciento de potencia un efecto medio, de medio punto de desviación típica, hacen falta unas 64 personas por grupo; para uno pequeño, de 0,2, unas 400; para uno de 0,1, que es del orden de muchos efectos reales en psicología, educación o nutrición, más de 1.500 por grupo.

El concepto nació con el contraste de hipótesis. Jerzy Neyman y Egon Pearson formalizaron en 1933 los dos errores que puede cometer una decisión estadística: rechazar la hipótesis nula cuando es cierta, que llamaron error de primera especie (type I error), y no rechazarla cuando es falsa, el error de segunda especie (type II error). Ronald Fisher, que había inventado el valor p unos años antes, solo se ocupaba del primero, y rechazó la idea con dureza durante el resto de su vida, pero la práctica se quedó con los dos. La probabilidad del error de primera especie es α, que se fija de antemano en 0,05. La del error de segunda especie se llama β, y la potencia es 1 − β. Lo que se convirtió en costumbre fue vigilar α con celo y olvidarse de β.

Jacob Cohen fue el primero en medir el olvido. En 1962 revisó los setenta artículos publicados en 1960 en el Journal of Abnormal and Social Psychology y calculó qué potencia tenían para detectar efectos pequeños, medianos y grandes. Para los medianos, que son los que un investigador suele esperar, la potencia media era de 0,48: en promedio, los estudios de la revista tenían menos probabilidades de encontrar un efecto real de tamaño razonable que de no encontrarlo. Cohen propuso que se calculara el tamaño de muestra antes de empezar y fijó las convenciones de 0,2, 0,5 y 0,8 para un efecto pequeño, mediano y grande, que se siguen usando. Veinticuatro años después, Peter Sedlmeier y Gerd Gigerenzer repitieron el análisis sobre su sucesora, el Journal of Abnormal Psychology, y publicaron el resultado en 1989 con un título que era una pregunta: ¿tienen algún efecto los estudios sobre la potencia en la potencia de los estudios? La respuesta era que no. La potencia no había subido.

En 2013, Katherine Button, John Ioannidis, Marcus Munafò y otros cuatro autores hicieron el cálculo para la neurociencia a partir de cuarenta y nueve metaanálisis, y estimaron una potencia mediana del 21 por ciento, que es la que aparece con los valores de partida de la figura. Lo que dieron a conocer no fue solo que se escapaban la mayoría de los efectos reales, sino una consecuencia menos obvia. Si la potencia es baja, una proporción mayor de los resultados significativos son falsas alarmas, porque los aciertos escasean y las falsas alarmas se mantienen en el 5 por ciento. Y los aciertos que se obtienen exageran el efecto.

La figura permite ver esa exageración pulsando «Hacer 200 estudios». Con un efecto real de 0,3 y treinta personas por grupo, los estudios miden efectos que van de −0,2 a 0,8, y solo los que caen más allá del umbral, en torno a 0,5, salen significativos. Pero esos son precisamente los que tuvieron suerte y midieron un efecto mayor que el real, así que el efecto medio de los estudios significativos queda en torno a 0,65, más del doble de la verdad. Andrew Gelman y John Carlin llamaron a esto error de tipo M, de magnitud, y señalaron uno peor, el error de tipo S, de signo: con potencia muy baja, una fracción apreciable de los estudios significativos encuentra un efecto en la dirección contraria a la real. A esa exageración se le llama también la maldición del ganador (winner’s curse), por analogía con las subastas, donde quien gana es, casi por definición, quien más había sobrevalorado lo subastado.

La maldición explica un patrón que se repite en muchas disciplinas: el primer estudio de un efecto encuentra una cifra espectacular, las réplicas encuentran efectos cada vez menores y el entusiasmo inicial se desvanece. Como los estudios pequeños solo se publican cuando salen significativos y solo salen significativos cuando exageran, la literatura publicada es una muestra sesgada hacia los efectos grandes. Cuando la Open Science Collaboration replicó cien estudios de psicología en 2015 con muestras mayores, el tamaño medio de los efectos se quedó en la mitad del original, que es aproximadamente lo que la potencia de los originales hacía esperar. Casos como el de las posturas de poder o el del agotamiento del ego siguieron ese camino.

Lo que se deduce de todo esto va contra la intuición de quien lee un estudio. Un resultado significativo con una muestra pequeña no es más impresionante por haber superado el umbral con pocos datos, sino más sospechoso, porque para superarlo ha tenido que medir un efecto grande, y los efectos grandes escasean. La respuesta de la estadística ha sido la que proponía Cohen en 1962: calcular la potencia antes de recoger los datos, a partir de una estimación honrada del efecto que cabe esperar, y registrar el diseño de antemano para que nadie pueda ajustarlo después. En los ensayos clínicos es obligatorio desde hace décadas. En buena parte de las ciencias sociales, sesenta años después del artículo de Cohen, la costumbre sigue siendo decidir el tamaño de la muestra por lo que cabe en el presupuesto y enterarse de la potencia, si acaso, cuando ya no tiene remedio.

Capítulo 10 de 10

Las comparaciones múltiples

Matemática y estadística 1276 palabras artículo suelto ↗

El problema de las comparaciones múltiples (en inglés, multiple comparisons) es que la probabilidad de encontrar por azar un resultado estadísticamente significativo crece con el número de cosas que se prueban. El umbral de significación habitual, un valor p por debajo de 0,05, garantiza que una hipótesis falsa solo pasará por verdadera una vez de cada veinte. Pero si se prueban veinte hipótesis falsas a la vez, lo esperable es que una pase, y la probabilidad de que pase al menos una es del 64 por ciento. Con cien, del 99. Quien busca en suficientes sitios encuentra siempre algo, y si solo cuenta dónde lo encontró, el resultado tiene el mismo aspecto que un descubrimiento.

Randall Munroe dibujó el problema en 2011 en una tira de su serie xkcd. Unos científicos investigan si las gominolas causan acné, y no encuentran relación. Les piden que prueben color por color, y prueban veinte. Diecinueve salen sin efecto; las verdes, con p menor que 0,05. Al día siguiente, el titular del periódico dice que las gominolas verdes causan acné, con un 95 por ciento de confianza y una probabilidad de uno entre veinte de que sea casualidad. La figura reproduce el experimento y lo generaliza. Cada punto es el valor p de una hipótesis, ordenados de menor a mayor en escala logarítmica, y la zona sombreada es la que se declara significativa según el criterio elegido.

Interactivo Elige cuántas hipótesis se prueban y cuántas tienen un efecto real, y haz estudios. Sin corrección, con veinte hipótesis y ningún efecto, casi dos de cada tres estudios encuentran algo. Bonferroni baja el umbral a 0,05 dividido por el número de pruebas y elimina casi todas las falsas alarmas, a costa de perder efectos reales; Benjamini-Hochberg sube el umbral con el puesto de cada valor p y controla qué fracción de los hallazgos es falsa.

Con los valores de partida, veinte hipótesis sin ningún efecto real, cada estudio es el de las gominolas. Unas veces no sale nada; muchas sale un color, y a veces dos. Al pulsar para hacer mil estudios, la proporción de los que encuentran al menos una falsa alarma se queda cerca del 64 por ciento que da la cuenta, uno menos 0,95 elevado a veinte. Ninguno de esos estudios ha hecho nada mal en cada prueba por separado. El error está en la suma: la probabilidad de equivocarse que se había fijado en el 5 por ciento era la de cada prueba, y lo que se ha hecho es darse veinte oportunidades.

El ejemplo más célebre de lo que pasa cuando no se corrige es un salmón. En 2009, Craig Bennett y otros tres neurocientíficos metieron en un escáner de resonancia magnética funcional un salmón del Atlántico comprado en un supermercado, muerto, y le enseñaron fotografías de personas en situaciones sociales mientras le pedían que dijera qué emociones sentían. Analizaron las imágenes con el procedimiento estándar, que prueba por separado si cada uno de los miles de vóxeles del cerebro, los píxeles tridimensionales de la imagen, se activa con la tarea, y sin corregir por el número de pruebas. Encontraron un grupo de vóxeles activos en el cerebro del pez. Con la corrección, desaparecieron. Lo presentaron primero como póster y lo publicaron en 2010 en una revista de resultados inesperados, con un subtítulo que era la tesis: un argumento a favor de la corrección adecuada para comparaciones múltiples. En aquel momento, una parte considerable de los artículos de neuroimagen no la aplicaba, y el estudio, que recibió el premio Ig Nobel de neurociencia en 2012, contribuyó a que hoy casi todos lo hagan.

La corrección más sencilla es la de Bonferroni, que debe su nombre al matemático italiano Carlo Emilio Bonferroni, autor en 1936 de la desigualdad en la que se basa, y que Olive Jean Dunn convirtió en 1961 en un procedimiento práctico. Consiste en dividir el umbral por el número de pruebas: con veinte hipótesis, cada una tiene que bajar de 0,05/20 = 0,0025 para contar. Así la probabilidad de que salga al menos una falsa alarma en todo el estudio, lo que se llama tasa de error por familia (family-wise error rate), no pasa del 5 por ciento. La genética usa una versión extrema: en los estudios que prueban un millón de variantes del genoma a la vez, el umbral de significación es de 5 × 10⁻⁸, que es aproximadamente 0,05 dividido entre un millón. La física de partículas exige cinco sigmas, un p del orden de uno entre tres millones, en parte por la misma razón: cuando se buscan picos a lo largo de todo un rango de energías, alguno saldrá por azar, y a eso los físicos lo llaman efecto de mirar en otra parte (look-elsewhere effect).

El precio de Bonferroni es la potencia. Con un umbral veinte veces más exigente, los efectos reales también cuesta más detectarlos, y si se prueban mil hipótesis el umbral es tan estricto que casi nada lo supera. Yoav Benjamini y Yosef Hochberg propusieron en 1995 cambiar la pregunta. En lugar de controlar la probabilidad de cometer una sola falsa alarma, controlar la proporción de falsas alarmas entre los hallazgos, que llamaron tasa de falsos descubrimientos (false discovery rate). El procedimiento ordena los valores p de menor a mayor y compara el que ocupa el puesto i con 0,05 × i/m, donde m es el número de pruebas: el umbral sube escalón a escalón, y se aceptan todos los valores hasta el último que queda por debajo de su escalón. En la figura se ve como una rampa. Si se ponen varias hipótesis con efecto real, Benjamini-Hochberg detecta más que Bonferroni y mantiene las falsas alarmas en torno a un 5 por ciento de lo que declara, no de lo que prueba. El artículo de 1995 es uno de los más citados de toda la estadística, porque llegó justo cuando la genómica empezaba a probar miles de genes a la vez.

Las correcciones resuelven el problema cuando se sabe cuántas pruebas se han hecho. El caso difícil es cuando no se sabe, porque las comparaciones no se hacen de una vez sino a lo largo de un análisis. Un investigador recoge datos y puede decidir qué variable medir entre varias parecidas, si excluir a los participantes que respondieron demasiado deprisa, si analizar a hombres y mujeres juntos o por separado, si controlar por la edad, cuándo dejar de recoger datos. Cada decisión es razonable por sí sola, y ninguna se toma con intención de engañar, pero todas se toman después de ver los datos, y cada camino posible es una comparación más. Andrew Gelman y Eric Loken lo llamaron en 2013 el jardín de los senderos que se bifurcan, tomando el título del cuento de Borges, y señalaron que el problema existe aunque el investigador solo haya recorrido un sendero: basta con que, si los datos hubieran salido de otra manera, hubiera elegido otro. Es lo que Joseph Simmons, Leif Nelson y Uri Simonsohn demostraron en 2011 con datos inventados, y lo que se ha llamado p-hacking cuando se hace a sabiendas.

Contra esa versión del problema no hay fórmula, y la solución que se ha ido imponiendo es de procedimiento: registrar el análisis antes de recoger los datos, de modo que el número de comparaciones quede fijado de antemano y cualquier otra se presente como lo que es, exploratoria. También cambia la manera de leer. Un hallazgo que sale de un estudio que probó muchas cosas, sobre todo si es sorprendente y el estudio no dice cuántas probó, merece la misma desconfianza que el titular de las gominolas verdes. Y el problema no es exclusivo de la ciencia: el inversor que prueba cien estrategias con los datos del pasado y se queda con la que habría ganado, el aficionado que encuentra en los datos de la lotería el número que «sale más», o el que se asombra de una coincidencia sin pensar en todas las que no ocurrieron, están haciendo, como en el problema del cumpleaños, comparaciones múltiples sin contarlas.

Este itinerario ordena artículos de la enciclopedia; cada uno vive también suelto, con sus fuentes y su historial. ¿Le falta un capítulo o le sobra uno? Dínoslo.

Todos los itinerarios →